274. H 指数
给你一个整数数组 citations ,其中 citations[i] 表示研究者的第 i 篇论文被引用的次数。计算并返回该研究者的 h指数。
根据维基百科上 h 指数的定义:h 代表“高引用次数” ,一名科研人员的 h 指数 是指他(她)至少发表了 h 篇论文,并且 至少有 h 篇论文被引用次数大于等于 h 。如果 h有多种可能的值,h 指数 是其中最大的那个。
示例 1:
输入:citations = [3,0,6,1,5]
输出:3
解释:给定数组表示研究者总共有 5 篇论文,每篇论文相应的被引用了 3, 0, 6, 1, 5 次。
     由于研究者有 3 篇论文每篇 至少 被引用了 3 次,其余两篇论文每篇被引用 不多于 3 次,所以她的 h 指数是 3。
示例 2:
输入:citations = [1,3,1]
输出:1
提示:
n == citations.length1 <= n <= 50000 <= citations[i] <= 1000
题意:
给你一个数组,求一个最大的 h,使得数组中有至少 h 个数都大于等于 h。
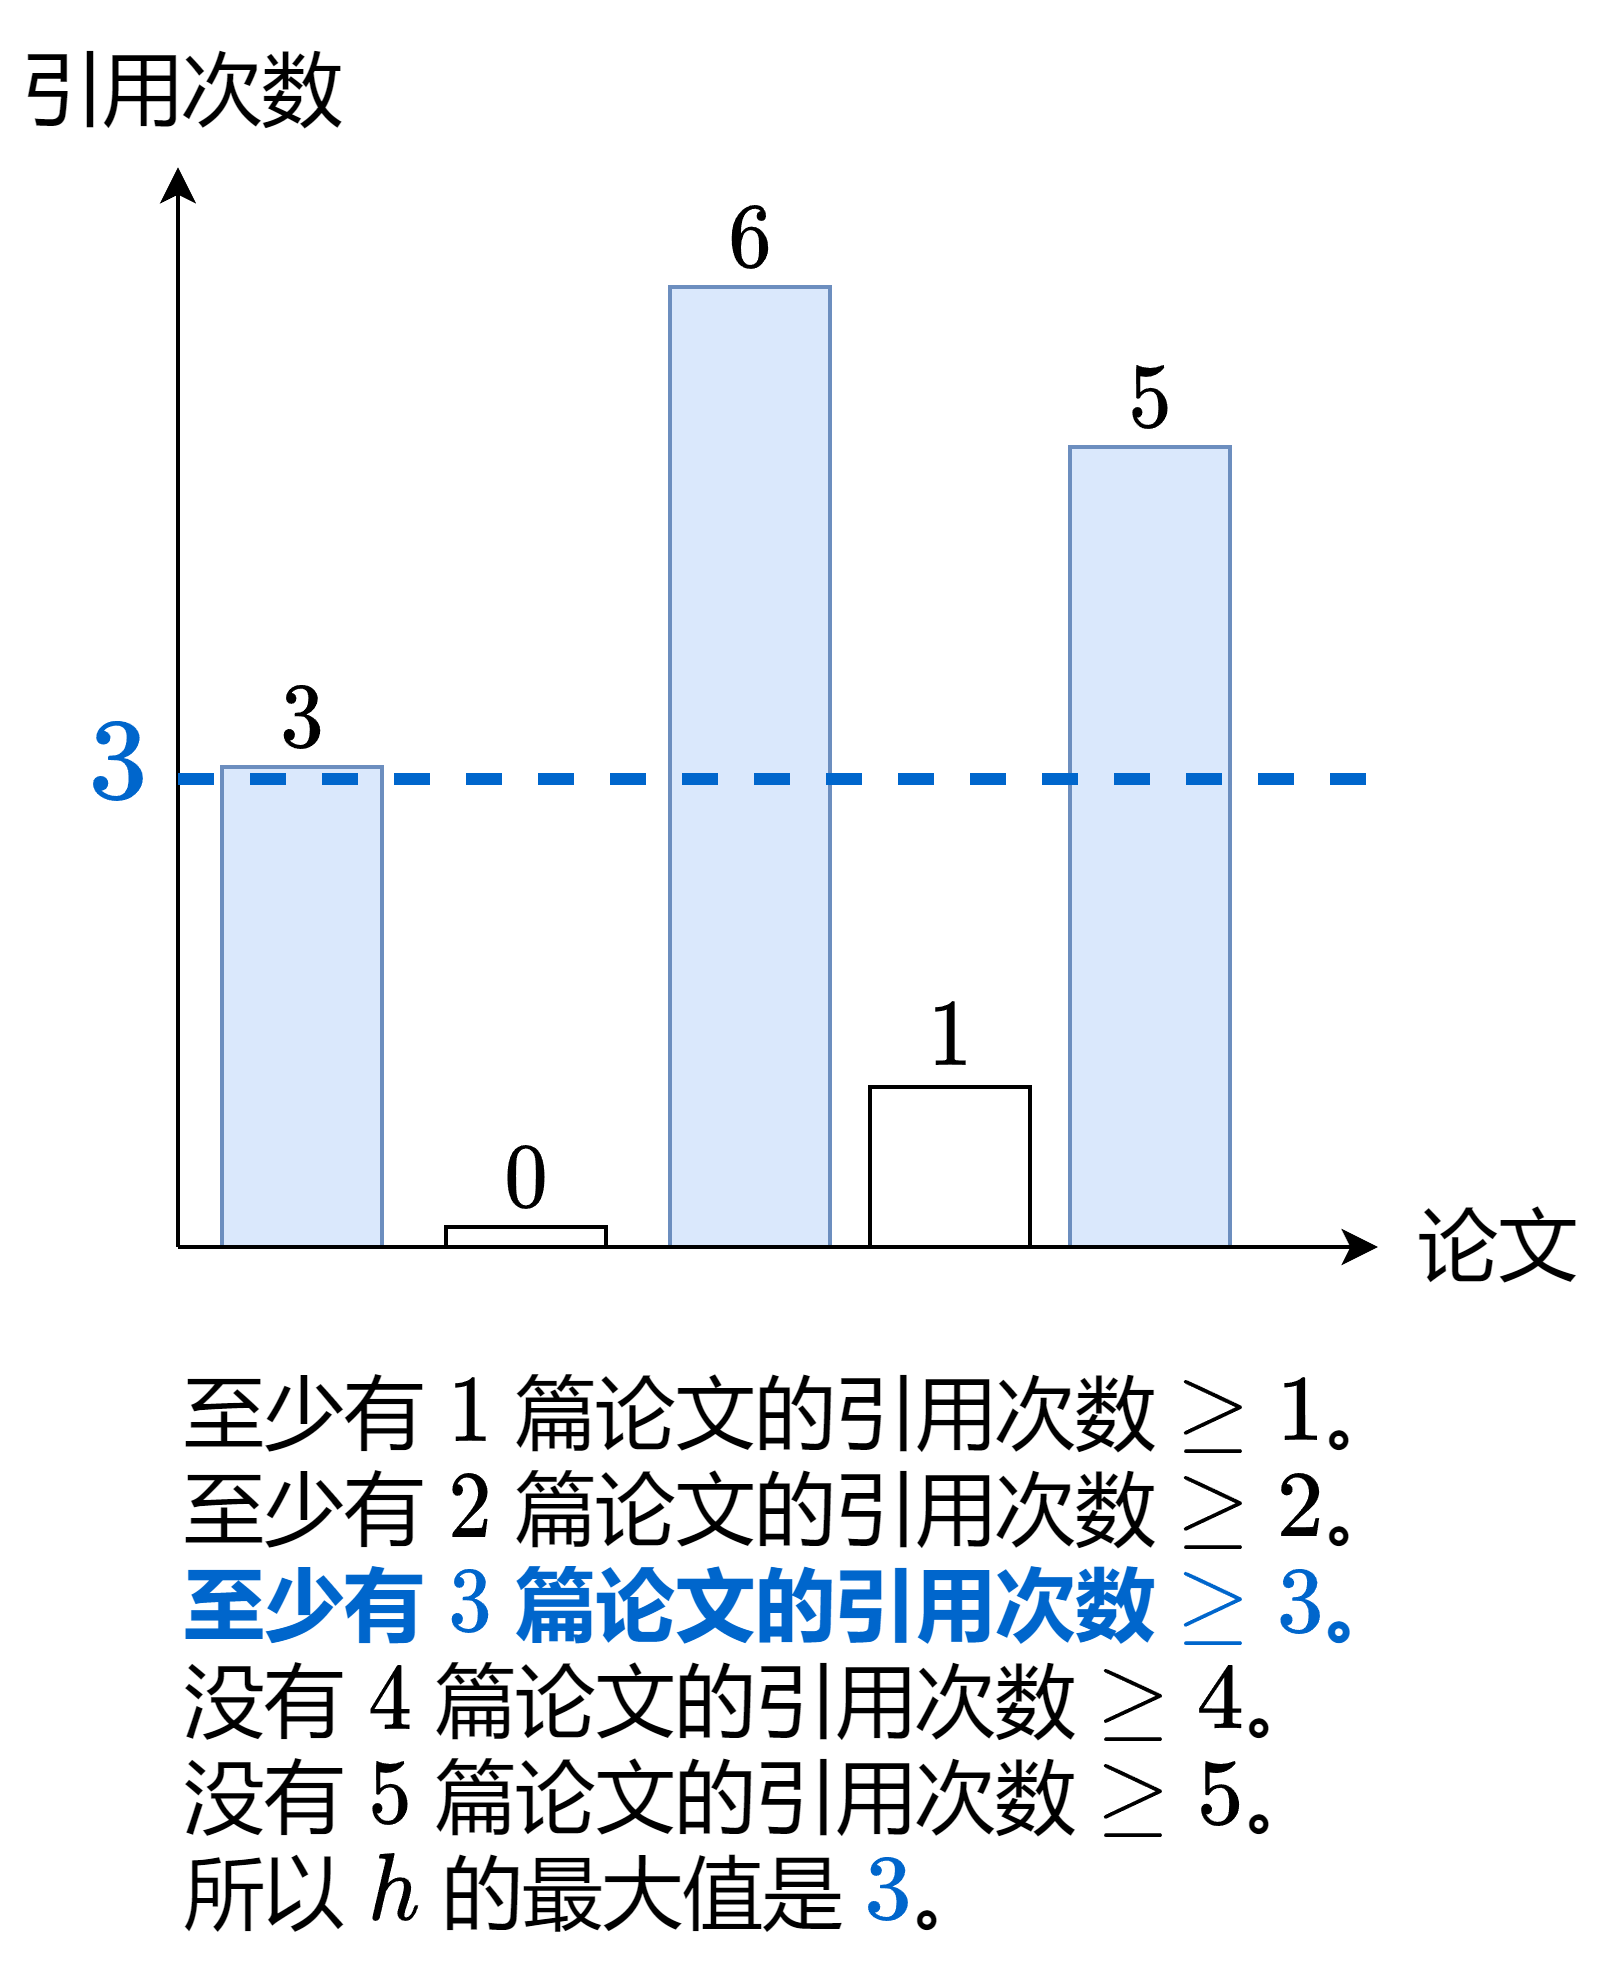
本题可以做到 O(n) 时间。
设 n 为 citations 的长度,即这名研究者发表的论文数。根据题意,h 不可能超过 n,所以对于引用次数大于 n 的论文,我们在统计的时候,可以看成是引用次数等于 n 的论文。例如 n=5,假设 h 是 5,那么无论引用次数是 6 还是 5,都满足 ≥5,所以 6 可以看成是 5,毕竟我们只需要统计有多少个数字是 ≥5 的。
所以,创建一个长为 n+1 的 cnt 数组,统计 min(citations[i],n) 的出现次数。
设 s 为引用次数 ≥i 的论文数,我们需要算出满足 s≥i 的最大的 i。
为了快速算出有多少论文的引用次数 ≥i,我们可以从 i=n 开始倒序循环,每次循环,把 cnt[i] 加到 s 中。由于我们是倒序循环的,只要 s≥i 成立,此时的 i 就是满足 s≥i 的最大的 i,直接返回 i 作为答案。
例如示例 1,从 i=5 开始:
i=5,现在 s=2<i,继续循环。
i=4,现在 s=2<i,继续循环。
i=3,现在 s=3≥i,返回 3。
class Solution {
    public int hIndex(int[] citations) {
        int n = citations.length;
        int[] cnt = new int[n + 1]; //创建一个数组,大小为n+1,即0,1,2...n共n+1,用于存储对应下标对应的引用次数
//比如`[3,0,6,1,5]`,引用0次→1,引用1次→1,引用2次→0,引用 3 次 →1,引用4次→ 0,引用5次→2(5和6都算作5);
// 所以最后数组为[1,1,0,1,0,2]
        for (int c : citations) {
            cnt[Math.min(c, n)]++; // 引用次数 > n,等价于引用次数为 n
        }
        int s = 0;
        // i--:倒着累加,直到s>i
//如:如果h=5 👉 但是cnt[5]=2 <5 所以不成立
// 如果 h =4 但是 2+cnt[4] = 2 <4 所以还是不成立
// 轮到 h=3 2+cut[3] = 3 = 3 所以成立了,h=3,就 return i;
        for (int i = n; ; i--) { // i=0 的时候,s>=i 一定成立
            s += cnt[i];
            if (s >= i) { // 说明有至少 i 篇论文的引用次数至少为 i
                return i;
            }
        }
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为 citations 的长度。
- 空间复杂度:O(n)。
作者:灵茶山艾府
来源:力扣(LeetCode)
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
但是这个解法有点难,我选择另一个解法:
时间复杂度为O(nlogn),但是会简单很多:
逆序排序
比如排序后[6, 5, 3, 1, 0],如果 citations[i] > i,那么前面的数必定大于i,所以找到i的最大值就是答案,因为 i从0开始,所以返回结果需要i+1
class Solution {
    public int hIndex(int[] citations) {
        Arrays.sort(citations);
        int n = citations.length;
        for (int i = 0; i < n; i++) {
            // 当前位置及后面共有 n - i 篇论文
            if (citations[i] >= n - i) {
                return n - i;
            }
        }
        return 0;
    }
}